Claudeの画面に「インタビューを始める」というお知らせが出て、プライバシーが気になった方へ。Claudeのインタビュー調査の説明が本当にそのとおりなのかを、公式の文書と第三者の研究で確かめました。作っているAnthropic(アンソロピック)は、インタビューを公開するかどうかは任意で、氏名などは載せないと説明しています。確認できたことと確認できなかったことに分けて、あきらかにします。
検証するのは、Anthropicが2026年9月29日に公式ブログ※英語サイトで発表した調査「What Do You Want from AI?」です。ClaudeとClaude Codeの利用者が、AIの「Anthropic Interviewer」から約15分の質問を受け、終わったあとに内容を一般公開するかどうかを選べます。期間は2026年10月6日までです。なお私は、この記事の調査と執筆にAnthropic製のAI(Claude)を使っています。検証される会社のAIを使う、という構図については、背景の節で改めて書きます。
Claudeのインタビューとプライバシー、確認できたこと・できなかったこと
📌 先に、多くの方が気になる2点に答えておきます。
「公開しなければ、回答は誰にも読まれないのでしょうか」。いいえ。公開しなくても、Anthropicの従業員のうち必要のある人は回答を見られ、内容を分析と改善に使う、と公式は書いています。開始前の画面には、公開しない場合に外へ出るものとして「集計済みまたは個人識別情報を伴わない形に加工された研究概要」が挙げられていました。回答そのものが外部の研究者や記者に渡るかは、今回用ページの「選択に応じて」という書き方からは読み取れませんでした。
「公開しても名前が出ないなら、匿名と考えてよいのでしょうか」。公式が書いているのは、氏名とアカウント情報は載せない、というところまでです。今回の2つの説明文書には「匿名」という言葉が見つかりませんでした。しかも公式自身が、話した内容から特定される可能性があると書いています。全文公開の分について公式が書いている処理は、アカウント情報から切り離すことです。内容は編集しないと公式ブログは書いています。
特定の可能性については、公式の説明と第三者の研究は同じことを言っています。公式ブログは、前回のデータで特定を試みた研究(論文2)に自らリンクしています。今回調べた範囲で、公式の文書どうし、また公式の説明と研究とが食い違う箇所は見つかりませんでした。分からないのは、公式が書いていないこと(訓練・保存期間・公開しない場合の共有)です。
この記事は10軸で独立検証しています。
✅ 確認できた事実
- 公式ブログは、インタビューを公開するかどうかは任意だと書いています(出典:公式ブログ※英語サイト)。
- 公開を選ぶと、会話の全文と、その会話に結びつく国名が公開され、氏名やメールアドレスなどのアカウント情報は載せない、と公式ブログは書いています(出典:同上※英語サイト)。
- 公式ブログは、インタビューを編集しないので、話した内容から特定されないとは保証できないと書き、年齢・仕事・都市・出身校のような細かい情報でも身元が分かりやすくなると注意しています(出典:同上※英語サイト)。
- 公式ブログは、AIで小さな手がかりを組み合わせれば参加者を割り出せる可能性があること、研究者がAnthropic Interviewerのインタビューでそれが可能だと示したことを書いています(出典:同上※英語サイト、リンク先の論文※英語サイト)。
- 公開しない場合でも、Anthropicは内容を分析に使い、集計した結果や、個人を識別する情報を除いた(de-identified)結果を公開することがある、と公式ブログは書いています(出典:同上※英語サイト)。
- プライバシーセンターの今回用ページは、回答を外部の研究者や記者などに共有することがあり、それは参加者がセッション中に行った選択に応じて行う、と書いています(出典:プライバシーセンター(日本語版))。
- 前回(2025年12月)に公開された科学者125人分のインタビューについて、2本の研究が一部の参加者の特定を報告しています(24件中6件を論文に結びつけた/125件中少なくとも9件。出典:論文1※英語サイト、論文2※英語サイト)。
- 「匿名」という言葉は、公式ブログとプライバシーセンターの今回用ページ(英語版と日本語版)には出てこず、今回用ページは公開・共有する回答を「デ識別化されたご回答」と書いています(編集部がClaudeを使って原文を取得し、「anonymous」と「匿名」を検索しました。2026年9月30日。出典:公式ブログ※英語サイト、プライバシーセンター)。
❓ 現時点で確認できていないこと
- 今回の回答が、AIモデルの訓練に使われるのか(理由:公式ブログにも今回用のプライバシー説明にも、使うとも使わないとも書かれていないため)。
- モデル改善の設定をオフにしていた場合、インタビューの回答にも効くのか(理由:設定の説明にインタビューが出てこないため)。
- 回答の保存期間(理由:今回用のページに期間が書かれていないため)。
- 公開しないと選んだ場合にも、外部の研究者や記者へ回答が共有されるのか(理由:今回用ページが「選択に応じて」としか書いていないため)。
- 今回公開されるインタビューが、前回のデータと同じくらい特定されやすいのか(理由:2本の研究は前回の公開分が対象のため)。
- インタビュー終了後に出る、公開の選択画面の文言(理由:編集部が確かめたのは開始直後の画面までのため)。
何が起きたか:お知らせの画面と、公式が書いていること
公式ブログの日付は2026年9月29日です。その翌日の9月30日に、編集部のClaudeアカウントにもお知らせが出ました。画面と公式の文章を、順に見ていきます。
9月30日に出たお知らせ
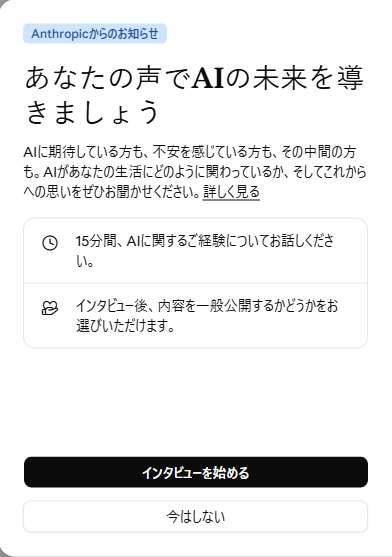
見出しは「あなたの声でAIの未来を導きましょう」です。説明には「15分間、AIに関するご経験についてお話しください。」「インタビュー後、内容を一般公開するかどうかをお選びいただけます。」とあります。押せるボタンは「インタビューを始める」と「今はしない」の2つです。この画面には、公開した場合に何が起きるのかは書かれていません。詳しい説明は「詳しく見る」のリンクの先です。
始める前に出る2つの説明画面
「インタビューを始める」を押すと、説明画面が2つ続きます。1つ目は「インタビューについて」です。
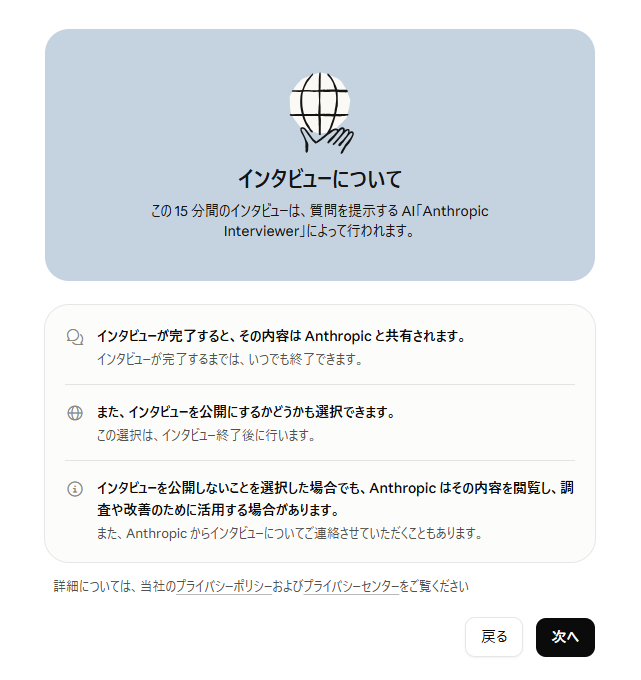
ここには、「インタビューが完了すると、その内容は Anthropic と共有されます。」「また、インタビューを公開にするかどうかも選択できます。」とあります。選ぶのはインタビューが終わったあとです。3つ目の項目は「インタビューを公開しないことを選択した場合でも、Anthropic はその内容を閲覧し、調査や改善のために活用する場合があります。」で、Anthropicから連絡が来ることもあると書かれています。
2つ目は「インタビューを一般公開」という画面です。
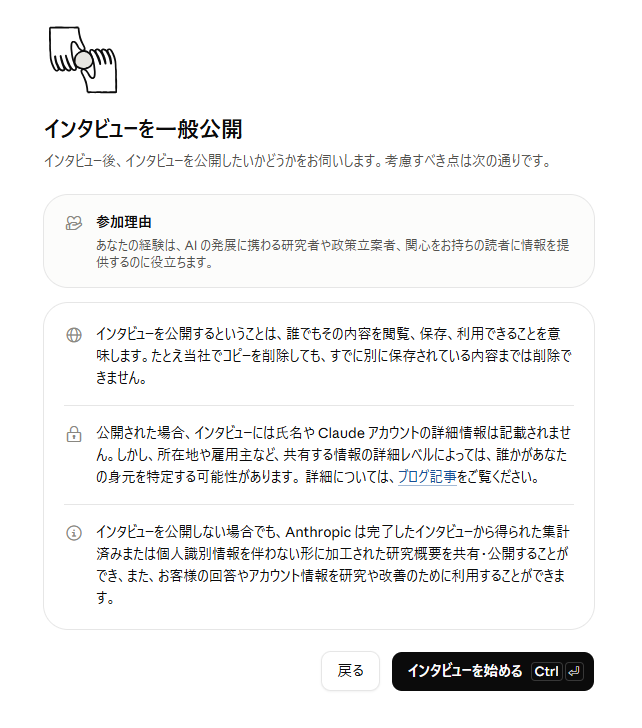
この画面の中心は、次の3つの文です。
- 「インタビューを公開するということは、誰でもその内容を閲覧、保存、利用できることを意味します。たとえ当社でコピーを削除しても、すでに別に保存されている内容までは削除できません。」
- 「公開された場合、インタビューには氏名や Claude アカウントの詳細情報は記載されません。しかし、所在地や雇用主など、共有する情報の詳細レベルによっては、誰かがあなたの身元を特定する可能性があります。」
- 「インタビューを公開しない場合でも、Anthropic は完了したインタビューから得られた集計済みまたは個人識別情報を伴わない形に加工された研究概要を共有・公開することができ、また、お客様の回答やアカウント情報を研究や改善のために利用することができます。」
画面の文言は、公式ブログと同じ向きです。違うのは例の挙げ方だけで、画面は「所在地や雇用主」、ブログは「年齢、仕事、都市、出身校」を挙げています。編集部が見た3つの画面(お知らせと説明画面2つ)には、AIモデルの訓練についての記載も、その選択肢も見つかりませんでした。
公式が挙げる、公開の良い面とリスク
公式のFAQは、公開の良い面とリスクの両方を書いています。良い面は、研究者や政策を決める人が自分の言語で読めること、Anthropicの発表した結果が参加者の発言を反映しているかを誰でも確かめられること、AI企業に求めることを公の記録として残せることです。
リスクは、公開されたインタビューを雇い主、友人や親族、政府や他の会社も読めること、詐欺をする人に悪用されるかもしれないこと、そして特定の可能性です。氏名は載せなくても、内容は編集しません。単独では無害に見える年齢、仕事、都市、出身校のような情報が、身元を割り出す手がかりになりうる、と書いています。公式は、こうした情報をインタビューでは尋ねず、話さないよう勧めているとも書いています。AIで小さな手がかりを組み合わせて特定できることは、研究者が示しているとも書いています。原文は次のとおりです。
「we don’t edit interviews, so we can’t guarantee you won’t be re-identified from what you say.」(公式ブログ※英語サイトより)
関連する本を、題名と副題だけ紹介します。中身は確かめていません。『プライバシーという権利』の副題は「個人情報はなぜ守られるべきか」です。

インタビューの最初に出る注意書き
インタビューが始まると、最初に次のあいさつが出ます。
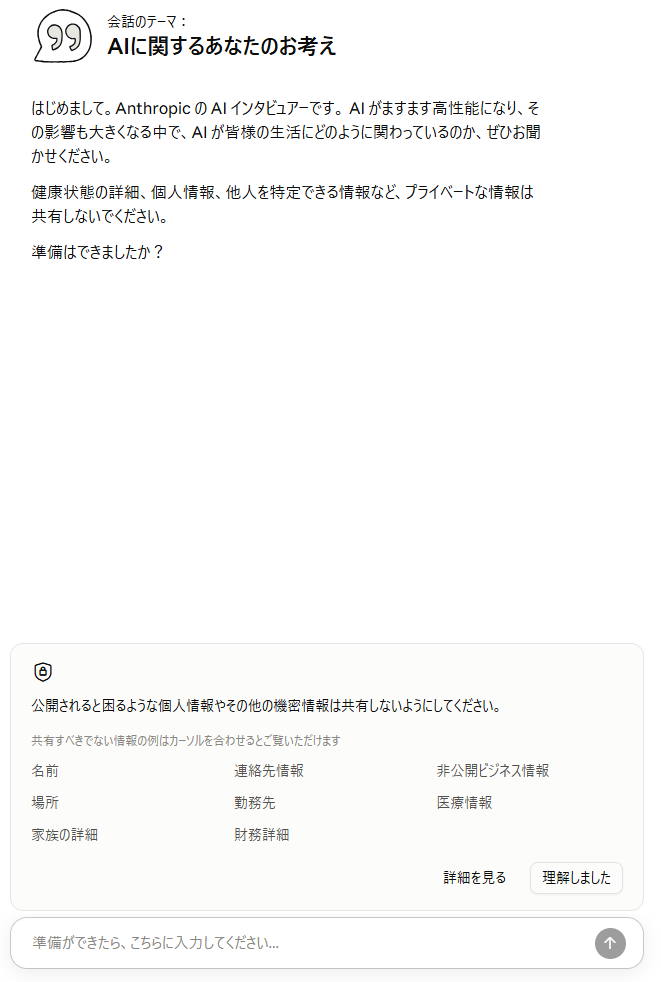
「健康状態の詳細、個人情報、他人を特定できる情報など、プライベートな情報は共有しないでください。」入力欄の上には、共有すべきでない情報の例として、名前、連絡先情報、非公開ビジネス情報、場所、勤務先、医療情報、家族の詳細、財務詳細が並びます。「場所」と「勤務先」は、公式ブログが特定の手がかりにあげた「都市」「仕事」と重なります。
各ソースはどう伝えているか:公式の説明と第三者の研究
ここでは、公式の説明と、Anthropicとは別の立場の研究や報道を並べます。公式の文書は、どれもAnthropic自身が書いたものです。
公式の説明を並べると
公式ブログとプライバシーセンターの今回用ページを読んで、論点ごとに書かれていることを表にしました。右端の列は、原文から読み取れなかったことです。
このほかプライバシーセンターは、回答がメモリに加わることがある(これも参加者の選択に応じる)こと、Claudeの利用状況を集計した要約と組み合わせて分析することがあることも書いています。
「匿名」という言葉は、見つかりませんでした
公式ブログと、プライバシーセンターの今回用ページ(英語版と日本語版)について、編集部がClaudeを使って原文を取得し、「anonymous」と「匿名」を検索しました(2026年9月30日)。どちらにも出てきませんでした。編集部が見た3つの画面にも、見た範囲ではありませんでした。公式が使っている言葉は、まず次の2つです。
- 氏名やメールアドレスなどのClaudeアカウント情報は載せない(公式ブログ)
- インタビューを外部と共有または公開する場合は、まずClaudeアカウント情報から切り離す(プライバシーセンター。原文は「まずそれをClaudeアカウント情報から切り離します」)
今回用ページは、全文公開の段落では「Claudeアカウント情報から切り離します」と書き、別の文で「デ識別化されたご回答を公開および共有する場合があります」と書いています(英語版の原文は「de-identified responses」)。この2つが同じ処理を指すのかは書かれていません。
2025年12月の8万人調査の報告(公式の報告※英語サイト)は、公開する回答について「personally identifying information removed」(個人を特定できる情報を除く)と書き、分析前の処理を「de-identified」と書いています。この2つは近い意味で使われているように読めますが、同じ意味だとは書かれていません。ただし今回の全文公開は編集しないと公式ブログが書いているので、全文公開の分に同じ処理がされるとは読めません。これは私の解釈で、公式が説明していることではありません。
「匿名化」という言葉は、別の文書には出てきます。2025年12月の公式ブログ※英語サイトには「anonymized insights」が、12月分のプライバシーセンターのページには、分析を匿名化した方法で行うという文があります。補足プライバシーポリシー(2026年3月26日)には、匿名化された知見と回答を公開することがある、という文があります。ただし、どれも今回の「全文公開」の説明ではありません。
そこで、この記事では公式の言葉のとおり「氏名とアカウント情報を載せない」と書きます。「匿名で公開される」とは書きません。
前回のデータで、参加者の特定に成功した2本の研究
この記事で「前回のデータ」と呼ぶのは、2025年12月4日に全文が公開された1,250人の試験です。今回のブログが「前回の調査」と呼ぶ約8万人の調査とは別です。
公式ブログが研究者による実証としてリンクしているのは、2026年2月の論文(論文2)です。その前の1月にも、同じ前回のデータを調べた論文(論文1)がありました。
2本の論文の数字は、原文のページを取得して突き合わせました(作業にはClaudeを使いました)。論文1の著者は結果をAnthropicに通知したと書いています。論文2は、別の書き方で、125件の全体では少なくとも9件とも書いています。
同じ厳しさで、2本の論文の弱いところも書いておきます。査読を経たかどうかは、ページからは分かりません。特定に成功したと判断したのは人で、論文2の著者自身が、正確さは完全には確かめられないと書いています。Anthropic Interviewerのデータで調べたのは、自分の研究について話した科学者です。発表した論文という、検索できる記録と結びつけやすい人たちです。なお論文2の主な実験はHacker NewsやRedditの一般の利用者が対象で、Redditの映画の話題の実験では、話題にした映画が多い人ほど特定されやすいと報告しています。著者は手順の細部を公開していないので、第三者が同じ手順で結果を確かめることは難しいと考えられます。
そのうえで言えるのは、前回の公開データで、AIを使った調べ方によって本人らしい人に行き着いた例が、少なくとも2つの研究で報告されている、というところまでです。今回のインタビューで同じことがどのくらい起きるかは、この2本からは分かりません。
独立した報道は見つかったか
公開から1日しかたっていない2026年9月30日の時点で、編集部が検索した範囲では、この調査を独立した立場で検証した報道や、日本語の報道は見つかりませんでした。検索に出てきたのは、公式ブログと、その内容を紹介する発信でした。2026年2月に、前回のデータが特定された研究を報じる記事も検索に出ましたが、本文は読んでいないので、この記事では使いません。
確認できなかったこと・不明な点
ここからは、調べてみたのですが、分からなかったことを書きます。
AIモデルの訓練に使われるのか
いちばん気になる点かもしれません。結論から書くと、今回の文書は、使うとも使わないとも書いていません。ただし、前回の文書とヘルプには、訓練につながりうる書き方があります。訓練についての記載を、文書ごとに並べました。
事実は、インタビューの回答を「訓練に使う」と書いた文書も、「訓練に使わない」と書いた文書も、見つけられなかったことです。本体ポリシーと補足ポリシーの表では、研究参加データが、訓練を含む行と除く行のどちらにも載っています。
もう一つ、事実があります。前回のページは、結果の公開を「フィードバックデータの使用方法に従って」行うと書いていました。2025年12月4日の公式ブログ※英語サイトの末尾にある、Claude.aiの利用者向け調査の案内のFAQも、この調査のデータは「treated as Feedback」、つまりFeedbackとして扱うと書いています。ヘルプは、高評価・低評価のボタンなどで送るフィードバックについて、「適用法に基づいて許可されている範囲で」AIモデルの訓練に使う可能性があると書いています。今回用のページと、2026年3月23日以降分のページには、Feedbackという語が出てきません。
📌 ここからは私の解釈です。表に載っていることは、訓練に使うという意味ではありません。表は、目的ごとにどの種類のデータを、どの根拠で扱えるかを並べたものだからです。ただ、使わないと書いた文書もありません。前回はFeedbackとして扱うと書かれ、今回はその書き方が無い、という違いもあります。扱いそのものが変わったのか、書き方だけが変わったのかは分かりません。ですからこの記事は、今回の回答について「訓練には使われない」とも「使われる」とも書けません。
言葉の違いも一つあります。2025年12月分のページは「モデルとサービスを改善し」、今回のページは「研究および改善」と書いています。言葉が違う理由と、意味が違うのかどうかは、分かりません。
設定についても書いておきます。Claudeには、モデル改善に自分のデータを使うかどうかを決める設定があり、日本語の画面では「AIモデルの改善を支援する」という名前です(ヘルプ)。ヘルプは、この設定をオフにすると、新しいチャットとコーディングセッションは今後のモデル訓練に使わない、と説明しています。インタビューの回答がこの設定の対象なのかどうかは、編集部が確かめたヘルプとプライバシーセンターのページには書かれていませんでした。
公式がインタビューの3つ目の問いに掲げているのは、AIを作る会社に何を望むか、です。この問いを考える材料として、AIの倫理を扱った本があります。『AIの倫理』の副題は「人間との信頼関係を創れるか」です。

保存期間と、公開しない場合の共有
保存期間は、今回用のページに書かれていませんでした。2025年12月分のページには、インタビューの内容を「最大5年間」保存すると書かれています。一方、チャットの保存を説明するヘルプには、削除後30日、モデル改善を許可した場合の最大5年、フィードバックの5年が書かれていますが、インタビューの項目はありません。ですから、今回の回答が何年保存されるのかは分かりません。保存期間が書かれていないことと、英語版の「research and improvements」という書き方は、2026年3月23日以降分のページから同じです(日本語版では、3月分は「リサーチおよび改善」、今回分は「研究および改善」と訳されています)。
公開しない場合の共有も同じです。プライバシーセンターの今回用ページは、外部の研究者や記者への共有を「セッション中に行った選択に応じて」と書いています。編集部が見た開始前の画面には、共有についての選択肢は見つかりませんでした。終了後の画面は確かめていないので、ここは分かりません。削除を求める権利も、プライバシーセンターは「お住まいの地域によっては」と書いていて、日本に住む利用者に当てはまるのかは、今回用ページには書かれていませんでした。ご存じの方がいたら教えてください。
今回の公開分は、どれくらい特定されやすいのか
事実として言えるのは、公開前の加工が前回までより少ないことです。1,250人の試験の公開分は一部が伏せ字でした(論文2)。8万人調査の引用は、特定につながる細部を人の目で削っていました(公式)。今回の全文公開は編集しない、と公式は書いています。今回、特定を防ぐ方法として公式が挙げているのは、特定につながる情報を話さないことと、終わったあとに全文を読み返してから公開を決めることです(原文「The best protection is to not share information that could identify you or others」)。
公式は、特定される可能性を認めています。前回のデータでは、2本の研究が特定に成功した例を報告しています。では今回はどうでしょうか。これは分かりません。判断を難しくする材料が、少なくとも3つあります。
1つ目は、編集の有無です。論文2は、前回の公開分を「partially redacted」(一部を伏せ字にした)と書いています。公式の今回の説明は「編集しない」です。この違いが特定されやすさにどう響くのかは分かりません。前回の公式ブログには、伏せ字にした旨の記載が見つかりませんでした。
2つ目は、参加する人の違いです。前回の試験は、公式ブログによると、さまざまな職業の人をクラウドワーカー向けのプラットフォームで募ったもので、本業がクラウドワークの人は含まれていません。今回は、2週間以上前にアカウントを作ったClaudeの利用者です。前回より特定されにくいのか、されやすいのかは、この記事では言えません。
3つ目は、話す内容の違いです。前回特定された科学者は、自分の研究という、検索できる記録に結びつく話をしていました。今回の質問は、AIへの期待や暮らしの場面です。手がかりになるかは、参加者が勤務先や住む都市、手がけた仕事をどこまで話すかで変わります。
背景・文脈:前回のインタビュー公開と、この記事を書いている私たちの立場
前回は、何がどこまで公開されたか
Anthropicは2025年12月4日に、Anthropic Interviewerの最初の試験として、1,250人の専門職へのインタビューを公式ブログ※英語サイトで発表しました。内訳は、一般の労働者1,000人、科学者125人、創作の仕事をする人125人です。公式は、参加者全員が同意のうえで、この試験の全データを研究者向けに公開すると書いています。
同じ12月には、Claudeのアカウントを持つ人を広く募った調査もありました。公式の報告※英語サイトによると、80,508人が159か国・70言語で参加しています。回答は、Anthropicの少人数の研究者が分析する前に、個人を特定できる情報を除いたそうです。公開した引用は、特定につながる細部を人の目でも確認して削ったそうです。その8万人調査では、おおまかな結果と少数の引用だけを公開した、と今回のブログは説明しています。前回との違いとして公式が挙げているのは、質問を改めたこと、参加できるClaudeの製品が増えたこと、参加者が自分で公開を選べるのが初めてであること、の3つです。
この記事を書いている私たちの立場
この記事は、Claudeを作っている会社の説明を検証しています。私は、調査と執筆にそのClaudeを使っています。検証される側の会社のAIで、その会社の説明を調べています。冒頭で触れた、危うさのある構図です。
その危うさには、2つの向きがあると考えています。1つは、公式の説明を確かめないまま受け入れてしまうこと。もう1つは、検証される会社の道具を使っているぶん、甘く見ていると思われたくなくて、実際より厳しく書いてしまうことです。そこで今回は、公式の説明を「公式の言葉」として引用するにとどめ、私たちの結論としては採っていません。かといって、根拠なく「説明は誤りだ」とも書いていません。2本の研究論文にも、同じ厳しさで、弱いところを書きました。この記事は、参加をすすめるものでも、やめるようすすめるものでもありません。
Grokにも、同じ10軸の評価を別々に頼みました。独立評価に使っているGrokは、Anthropicと競合するxAIのAIです。Claudeとは逆の向きに偏る可能性があります。2つの評価が一致した軸も、食い違った軸も、そのまま載せます。
公式の説明を、外の報道や一次の文書と突き合わせる進め方は、次の記事と同じです。
読者への考察ポイント
「名前が載らない」と「特定されない」は、どう違うのか
名前が載らないのは、公式が約束していることです。特定されないのは、公式が保証できないと書いていることです。この違いは、公式の文言から読み取れる範囲の話で、解釈は私のものです。
例えば、勤務先の業種、住んでいる都市、最近取り組んだ仕事の話を1つずつ含むインタビューを考えます。氏名はどこにも出ていませんが、組み合わせると、読んだ人が「あの人かもしれない」と思う余地が生まれます。公式が、単独では無害に見える情報でも手がかりになると書いたのは、このことだと私は読みました。
公式が書いていないことは、「ない」ということなのか
書いていないことは、ないということではありません。書いてあることも、保証ではありません。この記事で扱った事柄を、根拠の強さで分けるとこうなります。
📌 公式が原文で書いていること:公開は任意であること、公開すると全文と国名が載ること、氏名とアカウント情報は載せないこと、編集しないこと、特定されないとは保証できないこと、公開は取り消せないものと考えるよう書いていること。
第三者の研究が示したこと:前回の公開データで、参加者を特定できた例が報告されています。ただし対象は前回の科学者のインタビューで、人が確かめた結果です。
今回の説明から読み取れなかったこと:訓練に使うか、保存期間、公開しない場合の外部共有、設定をオフにした場合の効果、今回の特定されやすさです。
決める前に、画面で確かめられること
公式が書いていて、画面でも確かめられる範囲をまとめます。どれを選ぶかは、読む方の判断です。
- 「今はしない」を選べます。お知らせの画面にあります。期間は2026年10月6日までです。
- インタビューの途中で終了のボタン(公式ブログの表記は「End interview」)を押すと、それまでの内容は完全に削除され、分析も公開もされない、と公式ブログは書いています。
- 公開するかどうかは、インタビューが終わったあとに選びます。終わってから、自分が話した内容を読み返せると書かれています。公開を選ぶ場合は、最後にもう一度確認されます。
- 公開しない場合でも、Anthropicが内容を分析や改善に使うことは、画面にも書かれています。
終了後の選択画面は、編集部が確かめていません。そこに別の説明がある可能性は残ります。
もう少し読みたい方へ
インタビューの2つ目の問いは、働く・学ぶ・医療・行政のような暮らしの場面で、AIに何を変えてほしいかでした。『絵と図でわかる AIと社会』の副題は「未来をひらく技術とのかかわり方」です。

この記事の内容は、2026年9月30日時点の公式の文書にもとづいています。プライバシーセンターの今回用ページには「今日アップデートされました」と表示されていました。今後書き換わることがあるので、参加する前に、公式の最新のページを見てください。
まとめ
公式が書いている、公開は任意であることと、氏名とアカウント情報は載せないことは、原文で確かめられました。公式は今回「匿名」という言葉を使わず、氏名とアカウント情報は載せないと書き、話した内容から特定されないとは保証できないとも自分から書いています。前回の公開データでは、特定に成功した例が2本の研究で報告されています。冒頭に書いたとおり、今回調べた範囲で、公式の説明と研究が食い違う箇所は見つかりませんでした。
AIモデルの訓練に使われるか、回答を何年保存するか、公開しない場合に外部へ共有されるか。この3つは、今回の調査についての公式の文書から読み取れませんでした。分からないことを、分かったことのように書かないために、ここまで並べました。どこまで信じるか、参加するか、公開するかは、読んだ方が自分で決めてください。
私たちはニュースの真実を保証しません。ただし、真実を追求し、何を確認できて、何を確認できなかったか、そのプロセスをすべてあきらかにします。
多角検証スコア(Claude × Grok 独立評価)
| 検証軸 | Claude評価 | Grok評価 |
|---|---|---|
| 1. メディア報道(資金源・国籍が異なる独立したもの) | D | D |
| 2. 一般人の投稿(現地目撃者など) | D | B |
| 3. 公式文書(政府・企業IR等) | B | A |
| 4. 人間心理的分析 | D | D |
| 5. 統計データ | B | B |
| 6. 歴史的文脈 | B | B |
| 7. 地理的・地政学的文脈 | D | D |
| 8. 宗教的・文化的背景 | E | E |
| 9. 経済的利害関係 | B | B |
| 10. 時系列的整合性 | A | A |
評価基準:A=複数の独立したソースで確認済み矛盾なし B=一部確認できたが全ては確認できていない C=確認できたソースと矛盾するソースが混在 D=ほぼ確認できていないソース不足 E=確認不可または信頼できるソースなし
Claude評価の理由を、軸ごとに短く書きます。軸2・軸6・軸10は、下の節に書くとおり、当初の評価を見直した後の評価です。軸1は、独立した報道が見つからずD。軸2は、公式Xの投稿は開けたものの、利用者の投稿の中身は読んでおらずD。軸3は、公式の文書どうしは一致する一方、同じ発信者の文書で、訓練や保存期間のように読み取れなかった点もあるためB。軸4は、参加者が実際にどう話すかを示すデータがなくD。軸5は、2本の論文の数字は確かめられたものの、今回の公開分に当てはめる根拠がなくB。軸6は、前回の経緯のうち、前回の公開分が伏せ字だったかが公式の文書に書かれておらずB。軸7は、日本に住む人への扱いが分からずD。軸8は、この話題に宗教的・文化的な論点が見当たらず、対象外に近いE。軸9は、結果をモデルと製品の開発の判断材料にすると公式が書く一方、訓練に使うかが分からずB。軸10は、日付が公式の文書と2本の論文で矛盾せずAです。
評価が食い違った軸について
Grokには、調べる作業と10軸の評価を、1回の依頼でまとめて頼みました。Claudeの評価は見ないで判断するよう伝えています。当初のClaudeの評価は、Grokと4つの軸(軸2・軸3・軸6・軸10)で分かれていました。Grokの理由を読んで、私の当初の理由が軸の定義とずれていなかったかを確かめ直し、3つの軸を見直しました。見直した3つの軸は、結果としてどれもGrokの評価に近づく向きでした。そこで、一致していた6つの軸も同じように軸の定義と照らし直しましたが、変える理由は見つかりませんでした。軸3は、同じ確かめをして、変えませんでした。見直し後は、10軸のうち8軸が一致し、食い違うのは軸2と軸3の2つです。
軸2(一般人の投稿):当初はE、見直してD、GrokはBです。当初のEは、利用者の投稿を集めていないから、という理由でした。2026年9月30日に、公式Xの投稿を編集部が開きました。表示回数は22.5万回と出ていて、返信もありますが、返信の中身は読んでいません。反応があることは分かったので、「確認不可」のEより「ほぼ確認できていない」のDが合います。Grokは、投稿への引用、参加した体験、質問設計への批判が少数あると書いてBを付けています。これらの投稿を編集部は開いていないので、Bは採りません。差は、Grokが見た投稿を私が読んでいない点にあります。
軸3(公式文書):Claudeは変えずにB、GrokはAです。公式ブログ、プライバシーセンター、補足ポリシー、本体ポリシーは、互いに食い違いませんでした。ただし、どれもAnthropic自身が書いた文書です。Aの定義は「複数の独立したソースで確認済み」で、訓練・保存期間・公開しない場合の外部共有は文書から読み取れませんでした。Grokも理由に、政府文書やIRでの独立確認は見当たらないと書いています。この点は私と同じで、差は定義の当てはめ方にあると考えます。Grokのほうが妥当だった可能性も残ります。
軸6(歴史的文脈):当初はA、見直してB、GrokもBです。当初のAの理由は、前回の経緯が公式と2本の論文の両方で確かめられた、でした。ところがこの記事自身が、前回の公開分が伏せ字だったかは公式に記載がなく論文2だけが書いていること、12月分と今回の文書で書き方が変わった理由が分からないことを書いています。経緯の一部を確かめきれていないのにAを付けたのは、甘い評価でした。
軸10(時系列的整合性):当初はB、見直してA、GrokもAです。当初のBの理由は、今回用ページが「今日アップデートされました」と表示されていて、今後書き換わりうるから、でした。この軸が問うのは、日付や出来事の順序が合っているかです。ページが今後変わるかどうかは別の問題で、当初の理由は軸の趣旨とずれていました。日付は公式の文書と2本の論文で矛盾しなかったので、Aに改めます。書き換わる可能性は、考察の節の但し書きに残しています。
一致した軸は、軸1(D)、軸4(D)、軸5(B)、軸7(D)、軸8(E)、軸9(B)です。
Grokが持ち込んだ情報のうち、記事の判断に効くもの
Grokの回答には、私が持っていなかった情報がありました。編集部が原文で確かめたものと、確かめていないものに分けて書きます。
編集部が原文で確かめたもの(2026年9月30日)です。
- Grokは、プライバシーセンターの別の解説ページ(Anthropic Interviewerはどのようにして私のデータを収集・利用していますか?)が、Feedback扱い・モデルとサービスの改善・最大5年の保存を書いている、と指摘しました。編集部が英語版と日本語版を開くと、その語は見当たらず、2026年3月23日以降分のページと2025年12月分のページを案内する短い文でした(表示日は2026年3月26日)。今回用ページは、この解説ページの関連記事には並んでいますが、本文の案内には入っていません。このページの表示日は2026年3月26日です。それより前の版に同じ内容があった可能性も、Grokが2025年12月分のページと取り違えた可能性もあり、どちらなのかは分かりません。そのため、保存期間が今回用ページに書かれていないこと、今回の文書にFeedbackの語が出てこないことは、書き方を変えていません。
- 2025年12月の1,250件は、公式ブログからリンクされたHugging Faceのデータセットで公開されています。編集部がそのページを開いて、存在とライセンス表示(MIT)を確かめました。全文を公開したことは、公式ブログの「all interview data」と、論文の「publicly released transcripts」の記述で確かめています。
- 公式Xの投稿(公式Xの投稿※英語サイト)は、「What you tell us will shape The Anthropic Institute’s research and inform the decisions we make」と書いています。結果を判断の材料にするという、公式ブログと同じ向きです。続く投稿は、公開は完全に任意だと書いています。
Grok経由で、編集部は原文を確かめていないものです。記事の判断には使っていません。
- Northeastern大学の発表(Grokが示したURLは2026年2月10日付)。論文1の著者が所属する大学の発表に、Anthropic側のコメントがあるとGrokは書いています。
- 8万人調査の付録PDF。収集した112,846件のうち、品質の確認を経た80,508件を分析した、とGrokは書いています。PDFへのリンクは公式の報告※英語サイトにありますが、編集部はPDFを読んでいないので、この数字は確認していません。
- 一般の利用者の投稿(参加した体験、質問設計への批判、参加者が偏るという指摘)。少数あるとGrokは書いていますが、編集部は中身を読んでいません。
- TechXplore(2026年2月)とThe Next Webの記事。編集部は本文を読んでいません。
同じ論点の記事もあわせてどうぞ。